FLUX Image 3、Nano Banana 2.1、GPT Image 2.6 实测:便宜的改不动图,贵的编品牌
同一张香水图、同一段中文海报,用 FLUX Image 3、Nano Banana 2.1、GPT Image 2.6 各跑 7 个场景共 21 张:便宜的改不动图、会换人换瓶,贵的会自己编一个香水品牌,按像素算账相差 4.7 倍。
FLUX Image 3、Nano Banana 2.1、GPT Image 2.6 实测:便宜的改不动图,贵的编品牌
FLUX Image 3、Nano Banana 2.1、GPT Image 2.6 七场景 21 张对比图实测
在人工智能图像生成领域,分辨率与语义理解的平衡始终是工程落地的一大挑战。随着各家大模型在 2K 甚至更高分辨率画布上的持续迭代,单纯对比生成速度已失去意义。本次评测将剥离营销话术,从像素级成本、文字渲染、写实质感以及图生图保真度等维度,对三款主流模型进行实验室级别的横向对比。
想象一个真实场景:运营要在当天下午交三张图——一张节气海报、一张商品主图、一张把旧图里的水果换掉。这三张图分别该用谁,直接决定他会不会加班。这个日常抉择,正是本次横评的问题意识起点。
测试协议与成本核算:当画幅成为隐形变量
本次评测于 2026 年 11 月 6 日进行单次实测。测试协议规定:三款模型使用同一提示词、同一画幅比例、同一 2K 档、无参考图;图生图场景三款都使用同一张参考图。共 7 个场景乘 3 款等于 21 张对比图,另用 seedream 与 grok-image 生成 3 张参考图,合计生成 24 张。参考图故意用第三方模型生成,避免自己生成再自己改的偏差。文中所有对比图均为 AI 生成。测试走的是同一个 MCP 接口,model_name 分别传 flux-pro、gemini-flash、gpt-image,所有模型都在同一计费通道下计费。评测维度严格涵盖中文文字准确性、写实质感、语义与构图控制、图生图保真度、单位像素成本、多轮编辑稳定性。
在价格与画布方面,FLUX Image 3(接口键 flux-pro)3:4 比例输出 1776×2368 分辨率,单张实付 ¥0.205,约合每百万像素 ¥0.049,官方 1K 图定价 $0.048。Nano Banana 2.1(接口键 gemini-flash)3:4 比例输出 1792×2400 分辨率,单张实付 ¥0.49,约每百万像素 ¥0.115,官方 1K 定价 $0.0336、2K 定价 $0.0504、4K 定价 $0.113,2026 年 10 月 6 日 GA,基于 Gemini 3.6 Flash。GPT Image 2.6(接口键 gpt-image)3:4 比例只输出 1152×1536 分辨率,单张实付 ¥0.41,约每百万像素 ¥0.231,OpenAI 2026 年 11 月 4 日发布,API 分 Flare 与 Sunburst,按 token 计费,1024×1024 high 档约 $0.053 一张,没有独立分辨率开关,质量档提升的是细节不是画幅。
| 模型名称 | 接口键 | 3:4 输出分辨率 | 单张实付成本 | 每百万像素成本 | 官方参考定价 |
|---|---|---|---|---|---|
| FLUX Image 3 | flux-pro | 1776×2368 | ¥0.205 | ¥0.049 | 1K 图 $0.048 |
| Nano Banana 2.1 | gemini-flash | 1792×2400 | ¥0.49 | ¥0.115 | 1K $0.0336 / 2K $0.0504 |
| GPT Image 2.6 | gpt-image | 1152×1536 | ¥0.41 | ¥0.231 | 1024 high 档约 $0.053 |
图 1|同样标注 2K,单位像素成本并不在同一量级。GPT 换到 1:1 方图后只出 1024×1024,差距还会进一步放大。
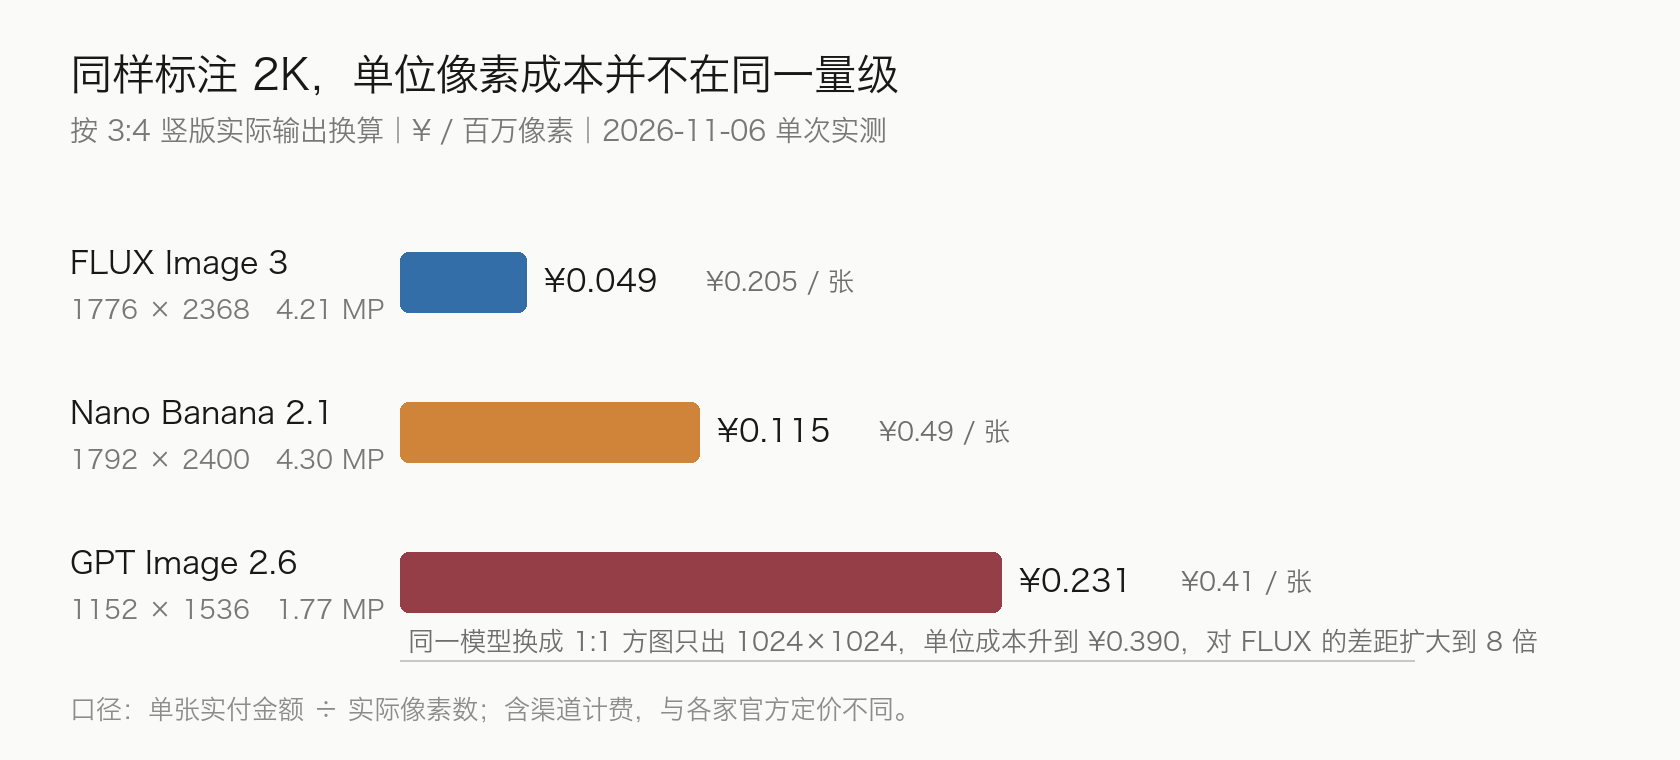
本轮单次实测的成本结论是:按张计价,Nano 是 FLUX 的 2.4 倍;但真正拉开差距的是单位像素成本——按 3:4 竖版算,GPT 每百万像素 ¥0.231,是 FLUX ¥0.049 的 4.7 倍;换成 1:1 方图,GPT 只出 1024×1024,单位成本升到 ¥0.390,差距扩大到 8 倍。24 张图两批实扣合计 ¥8.93,此为余额差额口径。
三款模型的出身决定了它们的强项
FLUX Image 3 出自 Black Forest Labs,2026 年 10 月 1 日 GA,走版式可控路线,强项是带坐标边界框和多参考图合成,官方定价 $0.048 一张 1K 图,另有开源 Klein 版本。Nano Banana 2.1 出自 Google,2026 年 10 月 6 日 GA,基于 Gemini 3.6 Flash,走对话式改图路线,强项是多轮编辑主体一致性,官方定价 1K $0.0336 / 2K $0.0504 / 4K $0.113。GPT Image 2.6 出自 OpenAI,2026 年 11 月 4 日发布,走商用交付路线,API 分 Flare 与 Sunburst,按 token 计费,1024×1024 high 档约 $0.053。路线不同导致同一提示词下暴露短板完全不同,这是后文差异的底层原因。
中文排版与文字渲染:从“写对”到“排好”的视觉差异
在 S1 短文案竖版海报场景中,标题两行“AI 出图 / 三种算法”,副标题“同一句话,三种答案”,三行小字“文字排版、写实质感、语义理解”。本轮单次实测显示,三款指定文字全部正确,无错字。
在 S5 长文本说明卡场景中,包含 7 行中文:先定画面比例、再定光线方向、写明禁止元素、标注文字位置、确认留白区域、最后检查错字。本轮单次实测表明,三款逐字正确、无掉字。
S3 语义与精确构图是一个 1:1 的信息图任务:左侧并排 3 个红苹果,右侧并排 2 个橙子,底部深色木牌写“3 : 2”,顶部细横幅写“水果配比”,要求数量精确、严格对称。本轮单次实测三款全部达标,数量、位置、文字都没错。这一关的区分度不如前两关,但它说明了一件事:只要指令足够具体,三款模型都不会在数数这种硬约束上翻车。
| 测试场景 | 提示词核心要求 | FLUX Image 3 表现 | Nano Banana 2.1 表现 | GPT Image 2.6 表现 |
|---|---|---|---|---|
| S1 短文案海报 | 两行标题+三行小字 | 文字正确,偏清爽平面 | 文字正确,版式规整 | 文字正确,字号偏大 |
| S3 精确构图信息图 | 3 苹果对 2 橙子,严格对称 | 数量与位置无误 | 数量与位置无误 | 数量与位置无误 |
| S5 长文本说明卡 | 7 行纯中文长段落 | 逐字正确,留白较多 | 逐字正确,对齐规范 | 逐字正确,接近印刷品 |
图 2|S1 中文短文案:三家文字全对,差别在版式与字重。左 FLUX、中 Nano、右 GPT。
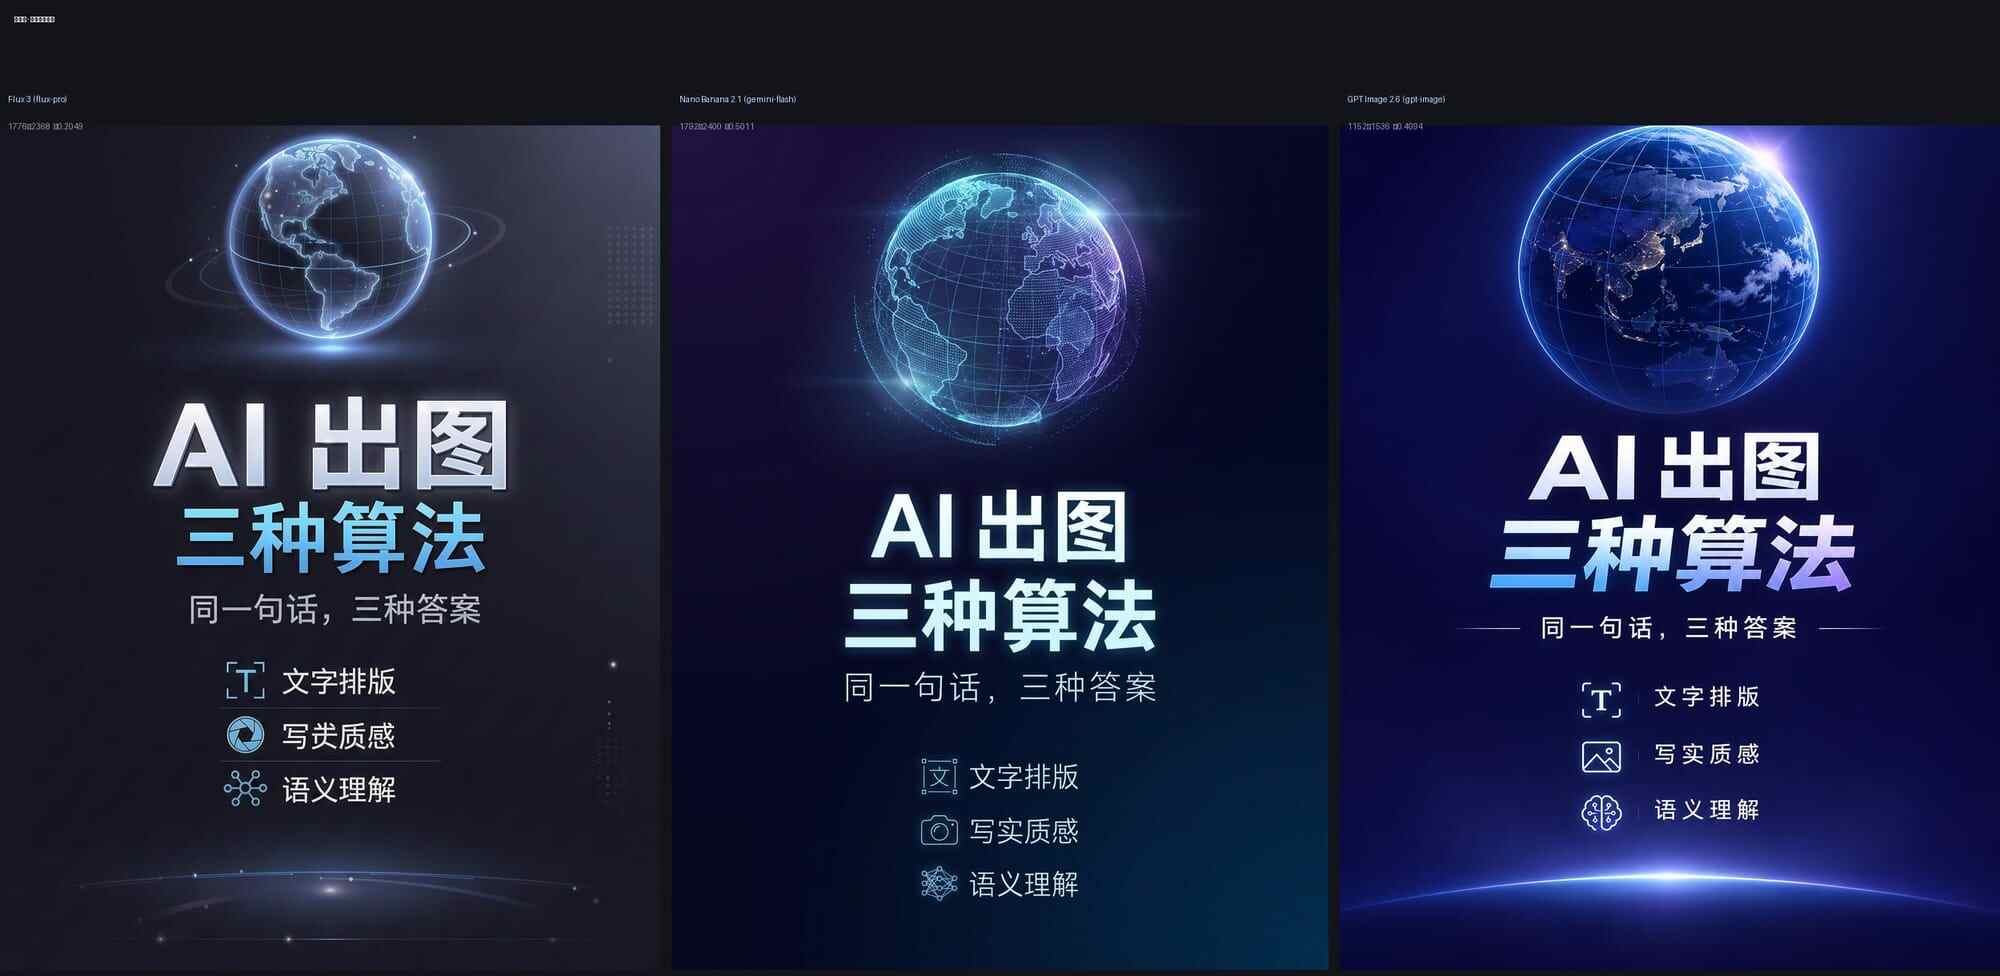
图 3|S5 七行长中文:三家逐字正确、无掉字,这是本轮最反直觉的结果。
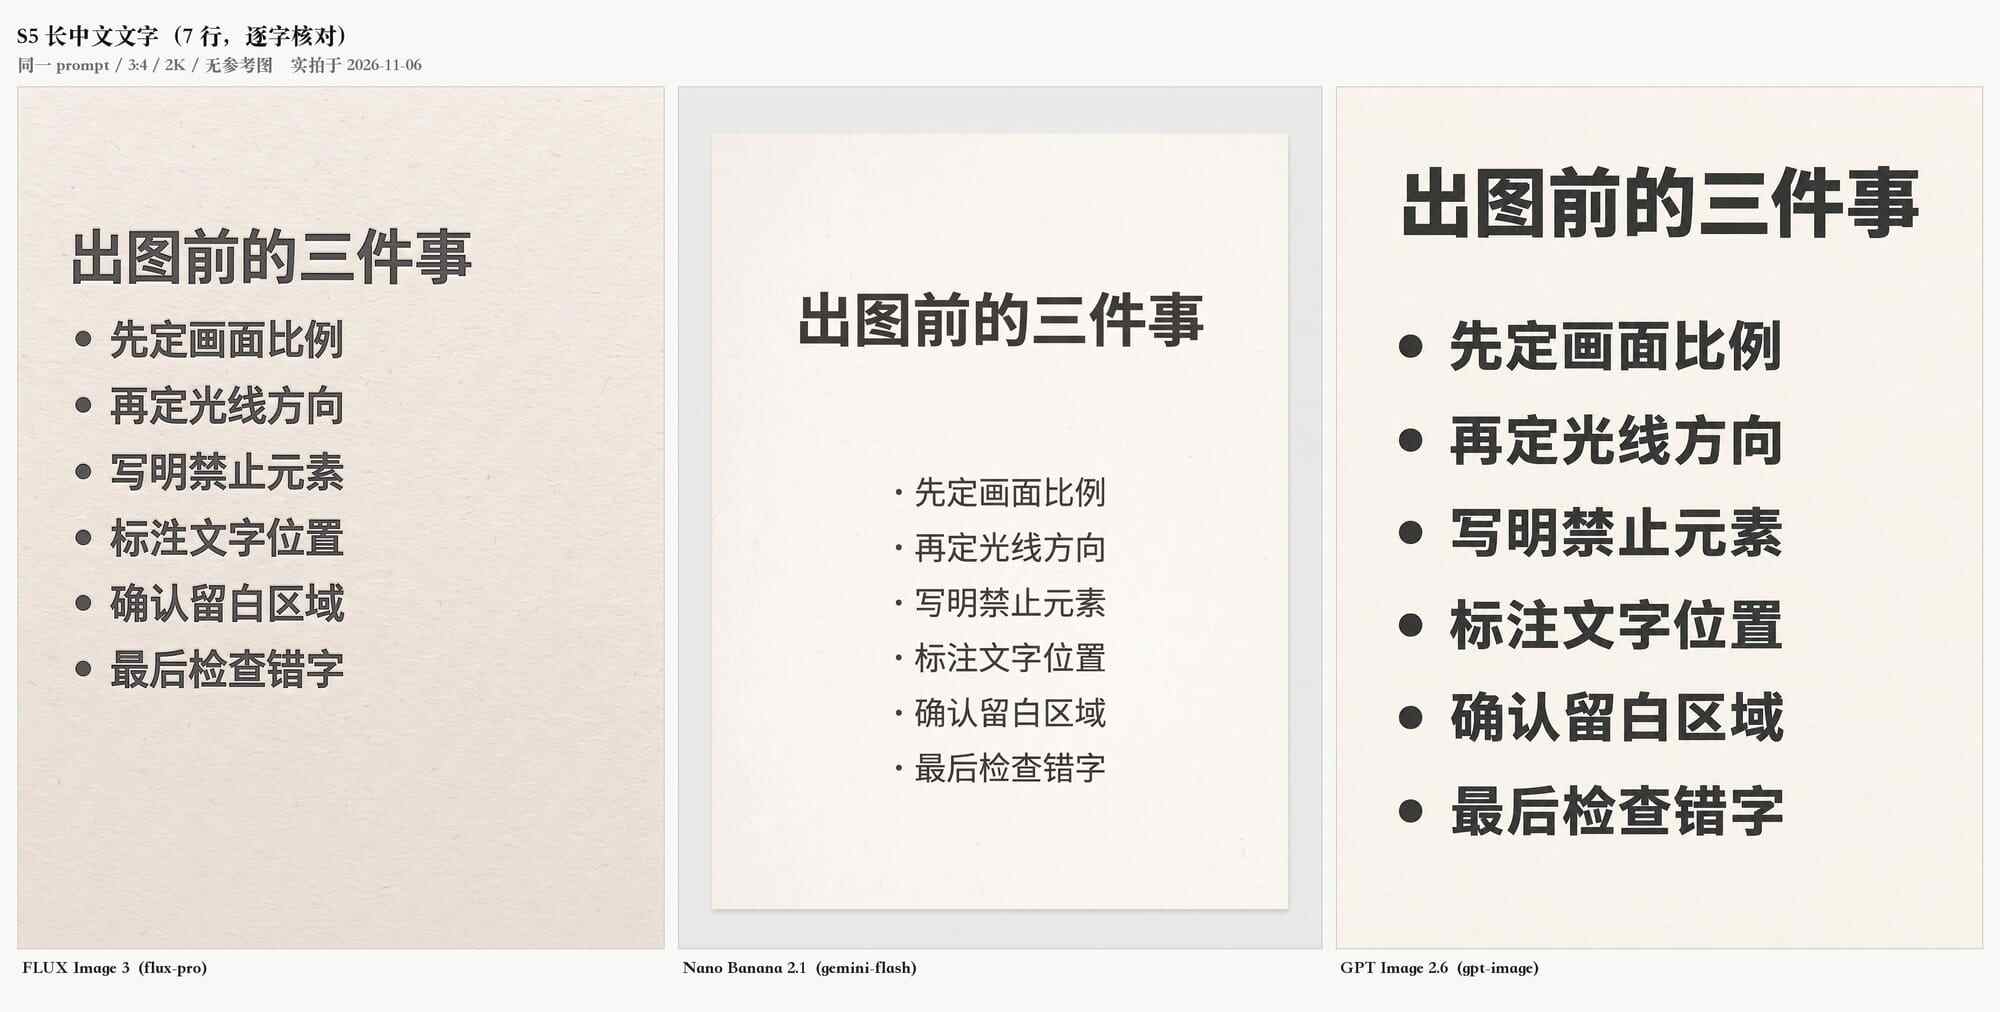
差异不在对不对,而在排得好不好看。从视觉呈现来看,FLUX 偏清爽平面,留白较多;Nano 版式规整,对齐方式更符合现代设计规范;GPT 字号偏大,字重较高,观感更接近传统印刷品。需要特别指出的是,FLUX 第一遍在整图上曾被读成“写关质感”,放大 3 倍裁切复核后确认实际是“写实质感”。这个细节说明看小字必须放大,否则评测本身就不可靠。
写实质感与指令遵循:商业摄影中的失控边缘
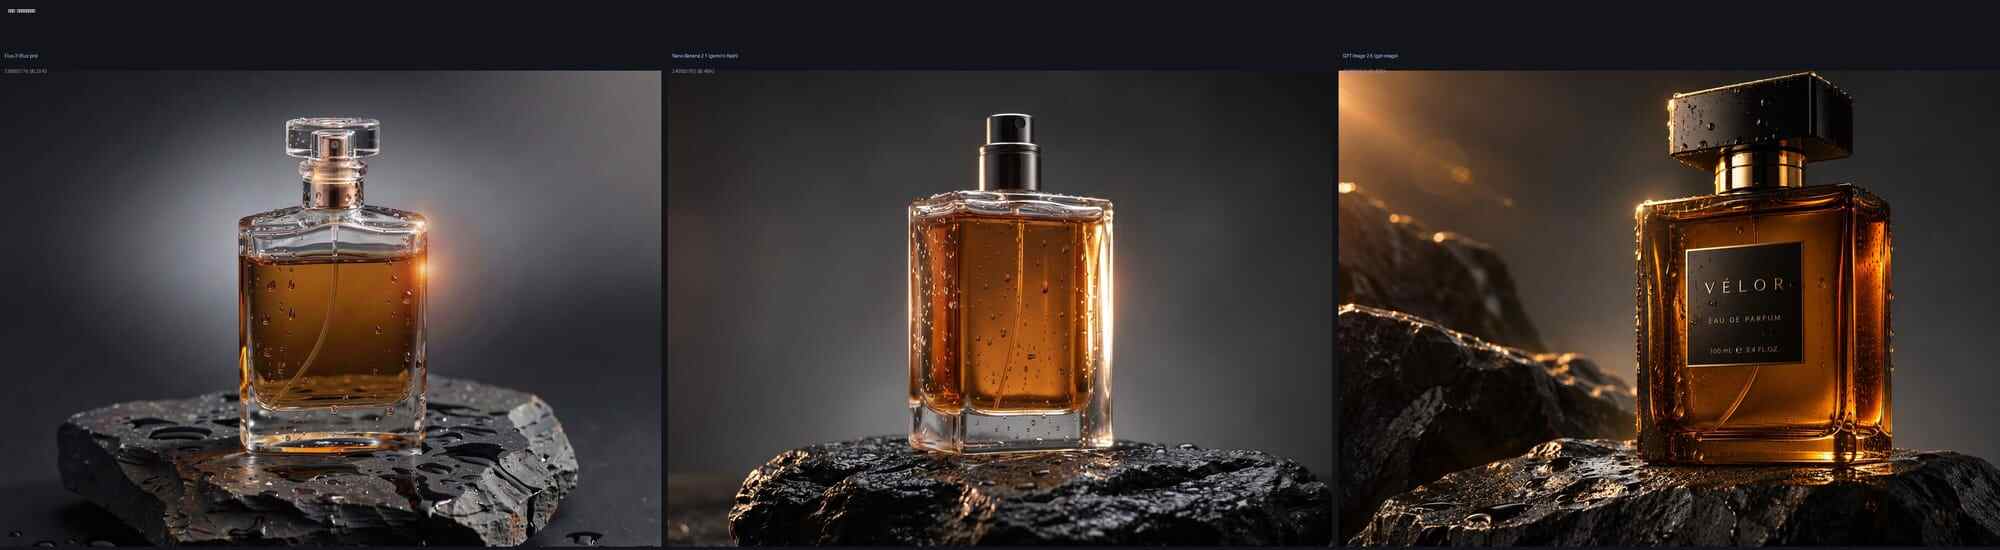
在 S2 香水产品摄影场景中,本轮单次实测显示,FLUX 遵守了“禁止任何文字”这一条指令,画面里没有任何标签,但整体偏干净,像修过的高亮棚拍。Nano Banana 2.1 光影评价更高,接近真实商业摄影,但瓶身与底座接触处有轻微融化感。GPT Image 2.6 质感评价居前,却违反“禁止任何文字”指令,自己印了一行假品牌标签 VÉLOR / EAU DE PARFUM / 100 ml。这比画面模糊更危险,因为肉眼看起来像正常商业排版,如果未经人工审核直接拿去投放,极易引发品牌侵权或虚假宣传的合规风险。
为什么模型会自己编品牌标签?商业产品摄影的先验里,瓶子就该有标签,模型把这个先验补全了,于是“遵守禁止文字”这条指令被先验压过去了。这不是随机错误,是可预期的系统性偏差,必须靠人工审字兜底。
图 4|S2 商业写实:左 FLUX 完全无字但偏“棚拍感”,中 Nano 光影更接近实拍,右 GPT 质感居前却凭空印出品牌标签。
图生图与局部编辑:保真度与语义理解的拉扯
在图生图与改图的三个场景中,本轮单次实测排名完全一致:Nano 优于 GPT 优于 Flux。
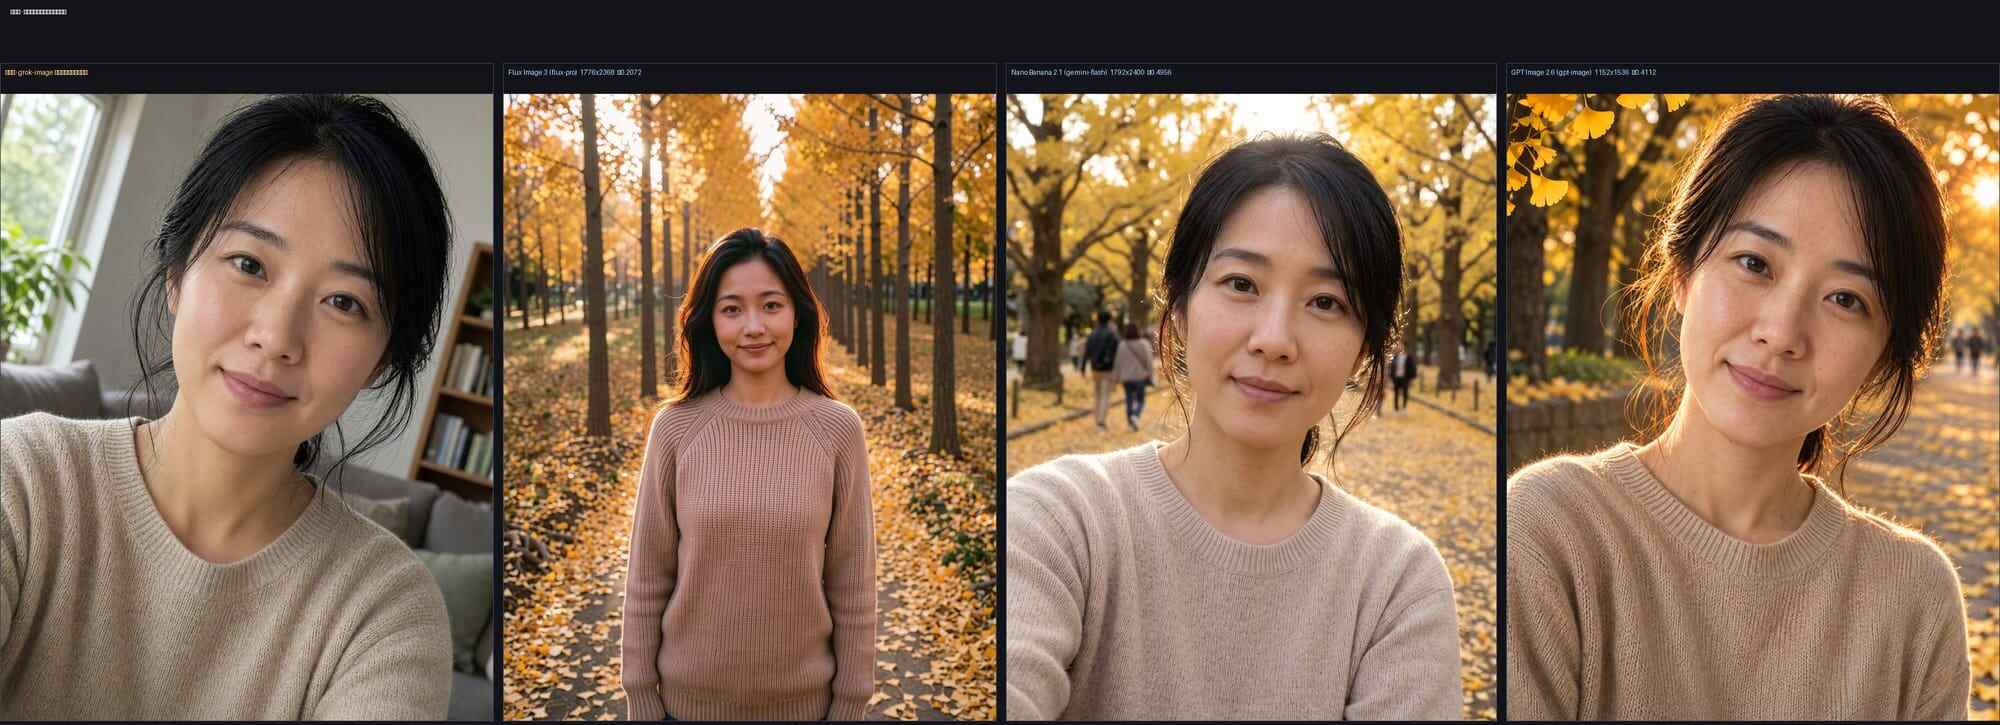
S4 商品换雪景场景中,Flux 把磨砂瓶改成透明瓶、白盖改成黑盖;Nano 保住了瓶型,但液面消失、水珠不符合物理;GPT 基本保住款式,露台空间感偏弱。S6 局部编辑(左两个橙子换柠檬)场景中,Nano 几乎只动了橙子;GPT 大体一致但有轻微缩放位移;Flux 把盘中整体放大裁切,小刀和餐巾移位。S7 人物换背景场景中,Nano 是同一个人、轻度美颜;GPT 是同一个人但面部中等漂移;Flux 直接换了人,呈现披散发、粉色服装、站姿。
| 图生图场景 | 核心编辑指令 | FLUX Image 3 表现 | Nano Banana 2.1 表现 | GPT Image 2.6 表现 |
|---|---|---|---|---|
| S4 商品换雪景 | 替换背景与材质 | 改变瓶身与盖子颜色 | 保住瓶型,液面消失 | 保住款式,空间感偏弱 |
| S6 局部编辑 | 替换盘中特定水果 | 整体放大裁切,元素移位 | 几乎只改动目标橙子 | 大体一致,轻微缩放位移 |
| S7 人物换背景 | 替换人物所处环境 | 直接更换人物形象 | 保持同一人,轻度美颜 | 保持同一人,面部中等漂移 |
图 5|S4 商品换雪景:最左为第三方模型生成的参考图,右侧三格为三款模型的改造结果。
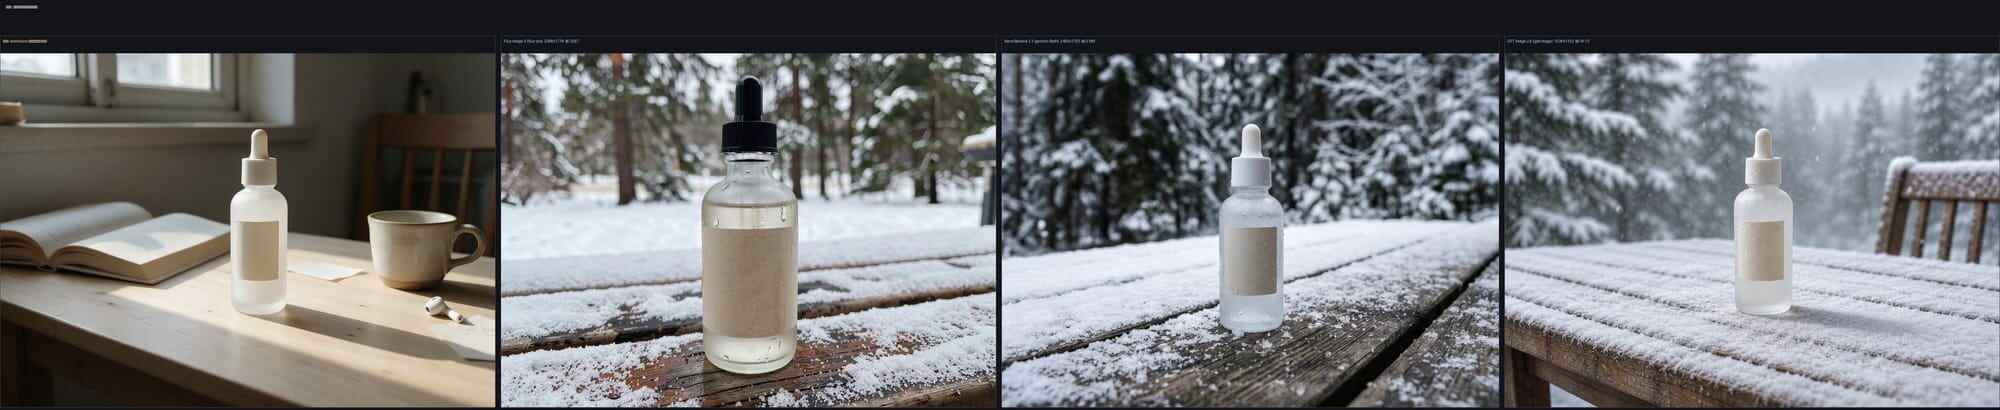
图 6|S6 局部编辑:指令只有一句“把左边两个橙子换成柠檬,其余不动”,差距全在“其余”上。
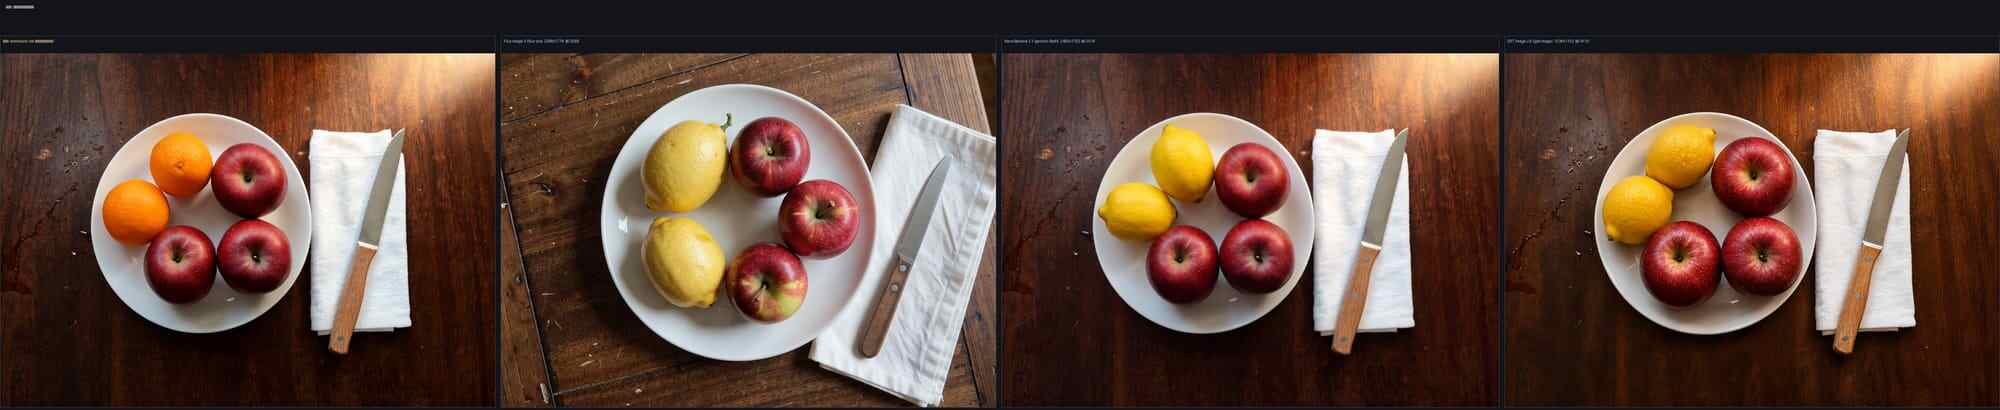
图 7|S7 人物换背景:要求保持人物完全不变,只换背景。最右的 FLUX 直接换了一个人。
机制解释方面,Black Forest Labs 的模型卡明确写着,FLUX 3 是按“完整场景描述”训练的,短提示只会得到泛化结果,强烈建议配提示词扩写器;参考图只锚定内容,不锁定构图;边界框只是位置条件不是硬遮罩,编辑可以改动框外内容,约 40×25 像素的小元素常常不出现。也就是说,FLUX 3 的主场是带坐标的版式控制,本轮走的是纯文本指令路径,它没有拿到自己的强项工具。
为什么本轮保真度排名和盲测排名不一致?盲测比的是“人看着喜欢哪张”,我们比的是“改完之后还是不是原来那件东西”。审美偏好和资产保真是两个目标,选型时不能拿一个榜去回答另一个问题。
反方证据:为什么第三方结论和我们相反
40 轮递归编辑测试(2026 年 10 月,12 条编辑链、480 次操作)记录的平均背景漂移是:Ideogram 4.5 为 0.95、FLUX 3 为 5.64、GPT Image 2.5 Sunburst 为 48.44、Nano Banana 2.1 为 100.48。FLUX 在“少改动”上明显更好,代价是约 5 至 7 处修改被漏掉或执行偏弱。
Fuser 在 2026 年 10 月 6 日的五项同提示词测试里给出的结果是:FLUX 3 胜 3 项、Nano Banana 2.1 胜 1 项、1 项打平,FLUX 赢在写实场景光线、已有商品编辑、参考人物相似度。所以准确的说法是,FLUX 擅长“保住原图”,不擅长“听懂一句口语化的改动指令”。这两个能力不是一回事。
Kingy 在 2026 年 10 月 15 日的 516 张图测试里统计:FLUX 3 完整版 28/32 通过四项检查、12/12 编辑通过;Nano Banana 2.1 31/32、12/12;GPT Image 2.5 Sunburst 29/32。三家都在 85% 以上,差距没有价格差那么大。
| 评测维度 | FLUX 3 完整版 | Nano Banana 2.1 | GPT Image 2.5 Sunburst | 备注说明 |
|---|---|---|---|---|
| 40 轮递归背景漂移 | 5.64 | 100.48 | 48.44 | 数值越低,保真度越高 |
| Fuser 五项测试胜场 | 3 项 | 1 项 | — | 仅两款参测,另 1 项打平 |
| Kingy 516 张图通过率 | 28/32 | 31/32 | 29/32 | 编辑测试均为 12/12 通过 |
| 盲测 Elo(文生图) | 1115 | 1172 | 1218 | Artificial Analysis 10 月快照 |
Artificial Analysis 图像竞技场 2026 年 10 月快照(人类盲投 Elo,文生图)排在前面的是:GPT Image 2.5 Sunburst 1218、GPT Image 2.5 Flare 1208、GPT Image 2 (high) 1186、Nano Banana 2.1 1172,FLUX 3 Image 完整版 1115 位居第 13。编辑榜上,Sunburst 1199、Flare 1180、Nano Banana 2.1 1151 排第 4,FLUX 3 Image 在核对的榜上没有条目。
关键限制在于,GPT Image 2.6 发布才两天,Artificial Analysis 上还没有它的任何一行分数。谁要是现在给你一个“GPT Image 2.6 综合第一”的结论,那不是测出来的,是猜的。
Google 自己的模型卡(2026 年 10 月)显示:信息图事实性 0.521(上一代 0.179)、多角色一致性 1106(上一代 978)、产品一致性 1024(上一代 955)。但同一份模型卡也承认:1K 下小字常模糊、长段落弱、角色一致性并非总是准确、左右方位偶有混淆。需要特别注意的是,这三家官方给出的自评数据和第三方盲测结果经常对不上,自评通常是同代产品之间的纵向对比,而盲测则是跨代、跨模型的横向混排,两者的测试口径完全不同,在实际参考时不宜混着用。
场景选型指南:没有全能选手,只有成本与容错率的权衡
基于上述实验室数据,我们得出以下选型结论:
对于需要批量生成封面、长图以及不带文字的商品底图的业务场景,推荐选择 FLUX Image 3。其每百万像素成本只有 GPT 的约五分之一,且输出画布更大,能够显著提升批量生产的性价比。
对于中文海报、信息图、任何“改一张已有图”的活,推荐选择 Nano Banana 2.1。其在三个图生图场景保真度都排前,代价是贵 2.4 倍,而且多轮改图会累积劣化。
对于要印刷级质感、并且有人能逐字校稿的场景,推荐选择 GPT Image 2.6。它质感好、速度快,但它会自作主张加文字,必须配人工审字。
如果只写文案、做纯文字排版,三家都够用,按价格选即可。
真实工作流通常是组合使用——用便宜的先出 20 张草图挑方向,选中的那一张再交给保真度高的模型做局部修改,最后人工校一遍文字。单独押注一款模型,通常在成本和返工之间二选一。
在构建自动化生图工作流时,许多团队开始尝试将仙踪问道 MCP 接入现有的设计管线,以统一调度不同模型的 API 接口。通过仙踪问道的标准化路由,开发者可以更直观地对比各家模型在特定业务场景下的实际表现,从而做出更理性的技术选型。
一句话总结:文生图看成本选 FLUX,改图优先 Nano,追质感且能兜底审字才上 GPT。
| 评测维度(权重) | FLUX Image 3 | Nano Banana 2.1 | GPT Image 2.6 |
|---|---|---|---|
| 单位成本(20%) | 5 | 2 | 1.5 |
| 画布尺寸(15%) | 5 | 4.5 | 2 |
| 改图保真(25%) | 1.5 | 5 | 3.5 |
| 中文排版(15%) | 3.5 | 5 | 4 |
| 写实质感(15%) | 3 | 4 | 5 |
| 指令遵循(10%) | 4 | 4 | 2 |
评分是本轮单次实测的主观归纳,权重按“商用交付”场景设定,换场景要重新加权。
欢迎持续关注本账号,获取更多硬核科技评测与效率工具解析。你在实际业务中更倾向于使用哪款模型?欢迎在评论区留言讨论。
仙踪问道 MCP 的接入说明和活动页在 https://www.xianzongwendao.com/activities